

Este recurso é fornecido por ayaka-notes/ayakaleaf-pro e está disponível a partir da v6.3.0. Seu feedback é bem-vindo caso encontre algum problema.
Assistente de IA e assistente de erros de LaTeX
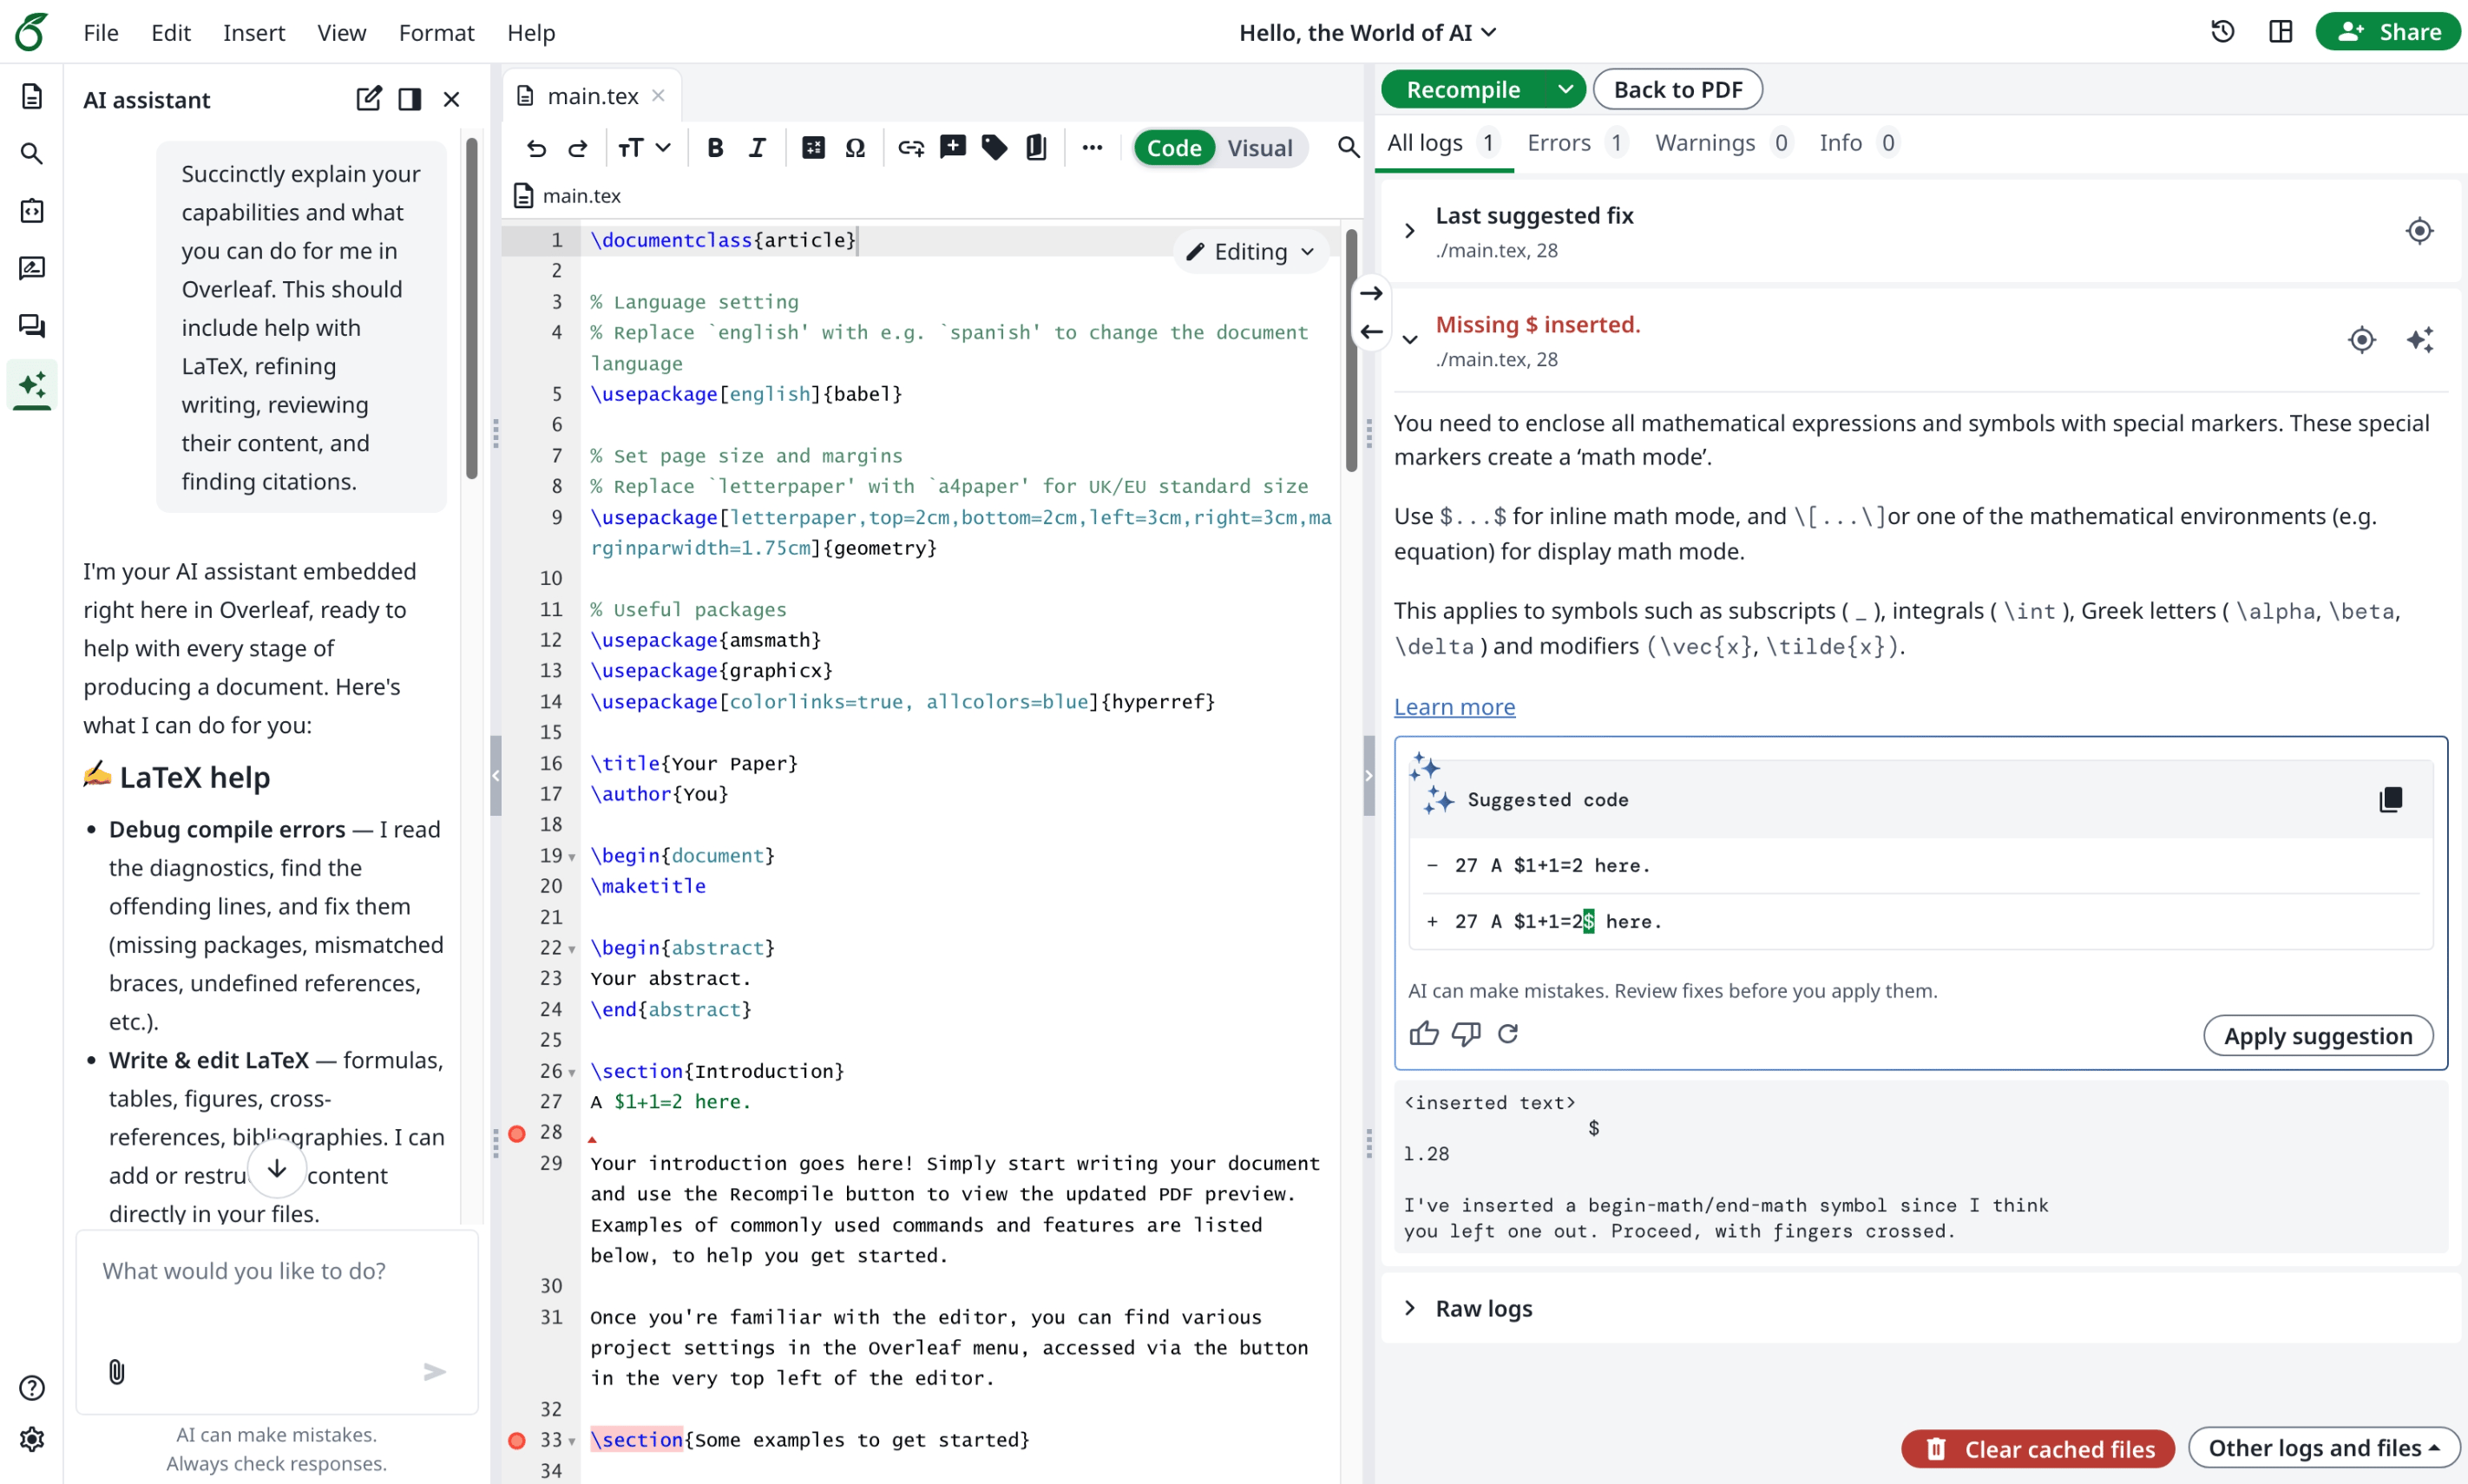
O Ayakaleaf Pro traz recursos de IA para o editor de duas formas.- O assistente de IA pode usar os documentos do projeto e a seleção atual como contexto para responder perguntas e sugerir edições para você revisar.
- O assistente de erros propõe uma correção direcionada quando você seleciona um erro de compilação LaTeX.
Configuração do Toolkit
Adicione o seguinte aoconfig/variables.env da sua implantação do Toolkit, substituindo a URL, a chave e o modelo de exemplo pelos valores do seu provedor:
A qualidade das sugestões de IA depende do modelo escolhido. Se você já tiver uma assinatura do Codex ou do ChatGPT, poderá conectá-la por meio do endpoint compatível com OpenAI do CLIProxyAPI.
AI_BASE_URL é a URL base da API compatível com OpenAI, incluindo o prefixo de versão do provedor quando necessário. Não acrescente /chat/completions, pois isso é feito internamente. O gateway e o modelo devem suportar chat completions com streaming e ferramentas de função (function tools). Ambos os recursos enviam contexto do documento para esse gateway; o chat também pode enviar imagens carregadas ao usar um modelo com suporte a imagens.
O Toolkit encaminha o config/variables.env para o contêiner da aplicação. Mantenha os nomes de variáveis mostrados aqui; não adicione o prefixo OVERLEAF_. No diretório do Toolkit, recrie o contêiner da aplicação após alterar essas variáveis:
Configurações do gateway
Para uploads de imagens, defina
AI_IMAGE_MODEL como um modelo que aceite entrada de imagens e suporte as ferramentas usadas pelo chat. Qualquer requisição de chat cujo histórico contenha uma imagem anexada usa esse modelo, incluindo mensagens posteriores dessa conversa. Sem essa configuração, as requisições com imagens usam o modelo de chat normal, que precisa suportar imagens. As sugestões para erros de LaTeX continuam usando AI_MODEL.
Por exemplo, para habilitar um modelo de imagens e uma cota semanal de IA:
Acesso dos usuários e consentimento
A disponibilidade na instância e a permissão do usuário são independentes.AI_ENABLED e a configuração do gateway controlam a disponibilidade na instância. Um usuário conectado também precisa passar pelas verificações de conta existentes:
aiFeatures.enablednão pode serfalse. Esse campo existente do banco de dados controla tanto o chat quanto as sugestões para erros de LaTeX.- O
features.aiUsageQuotaefetivo do usuário deve corresponder ao nível ilimitado configurado (unlimitedpor padrão), ou a permissão legada existentefeatures.aiErrorAssistantdeve estar habilitada. Os recursos efetivos incluem as substituições de recursos aplicáveis à conta.
aiUsageQuota é um nível de permissão, não uma cota numérica de tokens. AI_TOKEN_QUOTA é um limite separado aplicado igualmente a cada usuário autorizado; o módulo atual não oferece um limite numérico individual por conta.
Na lista de usuários do painel de administração, selecione um usuário e abra Update account info → AI features. Enable AI features atualiza aiFeatures.enabled quando as alterações da conta são salvas. O servidor verifica as permissões atuais em novas requisições de IA, incluindo requisições de um editor já aberto. Atualize o editor para que seus controles visíveis reflitam uma mudança de permissão.
Uso e redefinição
A aba de recursos de IA do painel de administração mostra, em uma única linha, o Usage do período atual, o Limit e o botão Reset. O uso é lido quando a aba é aberta; ele não é atualizado continuamente. Reabra a aba após a conclusão de um chat ou de uma sugestão de erro para ver a contagem mais recente. A redefinição tem efeito imediato e limpa apenas o contador do período atual daquele usuário, recarregando em seguida o uso exibido. Não é necessário salvar o restante do formulário da conta.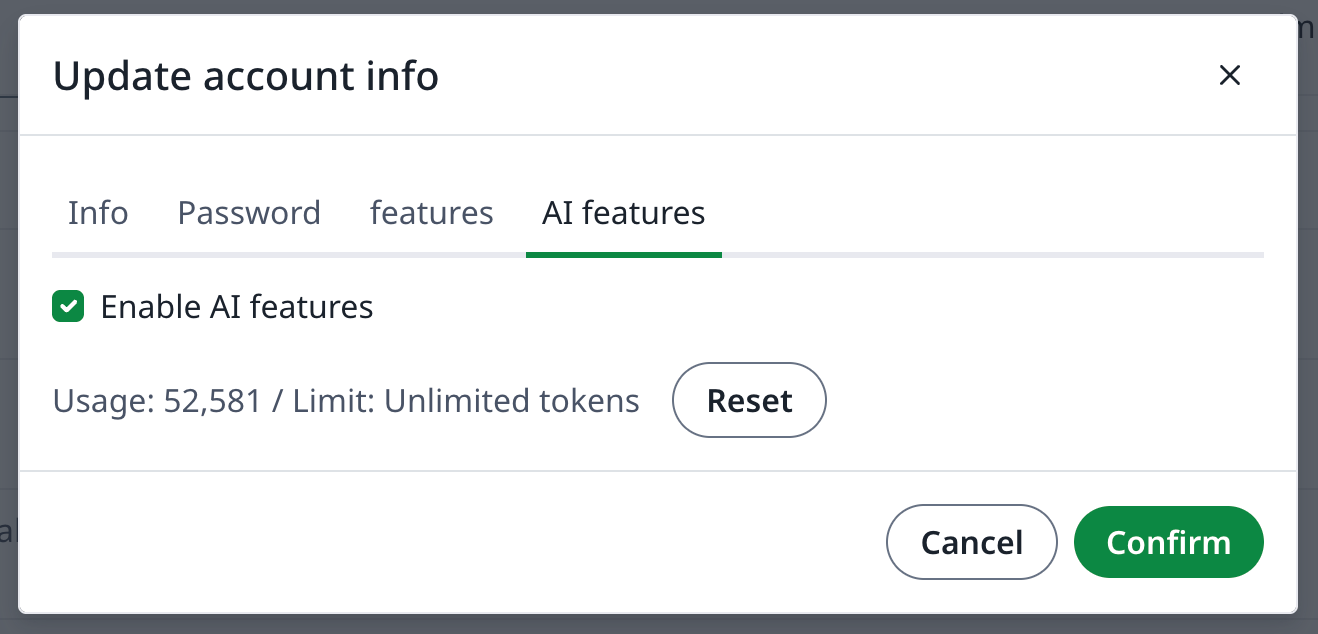
AI_TOKEN_QUOTA; as sugestões de erros não têm um limite separado de número de requisições. Redefinir o contador não altera a permissão, o consentimento, o limite configurado nem os registros de cobrança do próprio provedor. Os contadores usam chaves de período em UTC e expiram após 40 dias; manter os dados do Redis preserva o uso atual entre reinicializações da aplicação.
Serviços de pesquisa opcionais
A pesquisa na web usa uma API compatível com Tavily. Ela fica disponível quando uma chave de API de pesquisa está configurada. Essas configurações são independentes do gateway de IA:
Por exemplo:
searchDocumentation do endpoint GitBook MCP configurado e aceita respostas JSON ou SSE. Trata-se de um cliente MCP para pesquisa na documentação; esses módulos não expõem os arquivos do projeto como um servidor MCP nem fornecem um registro de servidores MCP de uso geral.
As consultas de pesquisa são enviadas ao serviço de pesquisa configurado. Os resultados podem então ser incluídos nas requisições ao gateway de IA. O menu Tools do chat permite que os usuários habilitem ou desabilitem Web e Documentation em suas requisições; uma ferramenta também precisa estar configurada no servidor para ficar disponível ao modelo.