> ## Documentation Index
> Fetch the complete documentation index at: https://ayakaleaf-pro.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# Integracja AI
> Skonfiguruj czat AI, sugestie dotyczące błędów LaTeX, dostęp użytkowników, limity oraz opcjonalne usługi wyszukiwania.
Ta funkcja jest dostarczana przez [ayaka-notes/ayakaleaf-pro](https://github.com/ayaka-notes/ayakaleaf-pro) i jest dostępna od wersji v6.3.0. Jeśli napotkasz jakiekolwiek problemy, chętnie poznamy Twoją opinię.
## Asystent AI i asystent błędów LaTeX
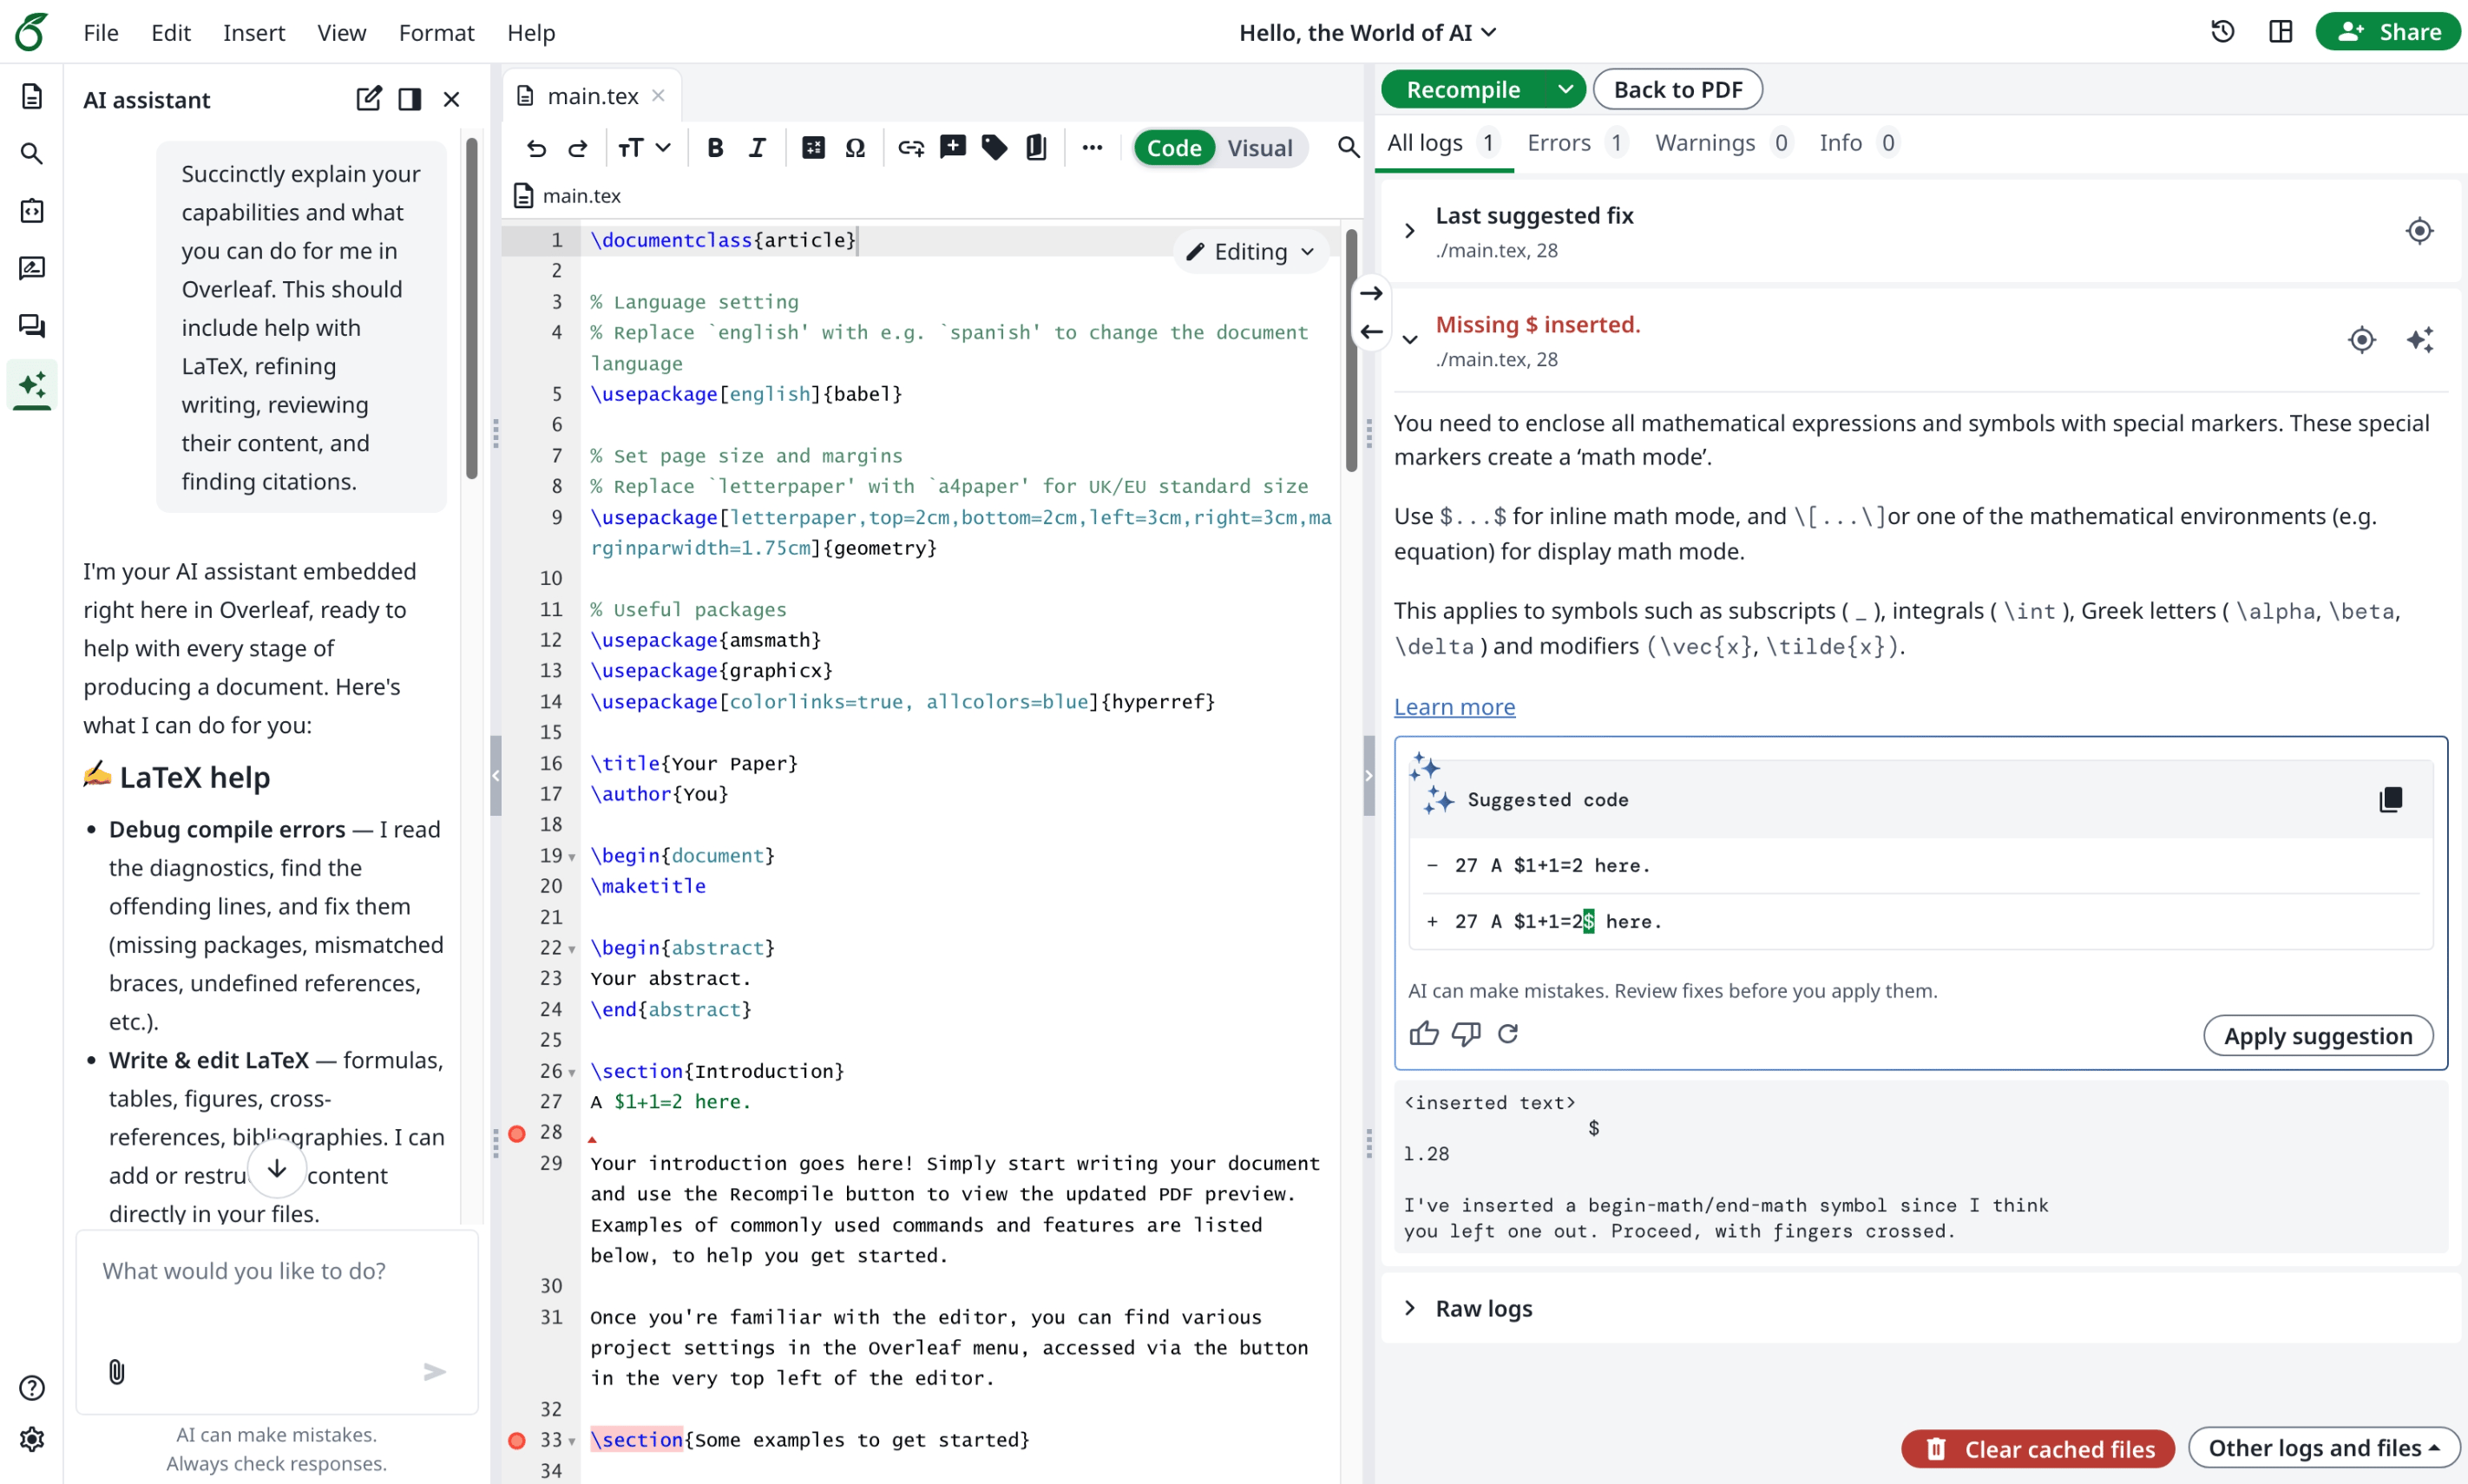
Ayakaleaf Pro wprowadza funkcje AI do edytora na 2 sposoby.
* Asystent AI może wykorzystywać dokumenty projektu i bieżące zaznaczenie jako kontekst, aby odpowiadać na pytania i proponować zmiany do Twojej weryfikacji.
* Asystent błędów proponuje ukierunkowaną poprawkę po zaznaczeniu błędu kompilacji LaTeX.
 ### Konfiguracja Toolkit
Dodaj poniższe wpisy do `config/variables.env` we wdrożeniu Toolkit, zastępując przykładowy URL, klucz i model wartościami od swojego dostawcy:
```dotenv theme={null}
AI_ENABLED=true
AI_BASE_URL=https://ai-gateway.example.com/v1
AI_API_KEY=REPLACE_WITH_YOUR_GATEWAY_API_KEY
AI_MODEL=YOUR_TEXT_MODEL_ID
```
Przechowuj prawdziwe klucze API w pliku środowiskowym wdrożenia, poza systemem kontroli wersji. Powyższe wartości są symbolami zastępczymi, a nie działającymi danymi uwierzytelniającymi.
Jakość sugestii AI zależy od wybranego modelu. Jeśli masz już subskrypcję Codex lub ChatGPT, możesz ją podłączyć za pośrednictwem endpointu zgodnego z OpenAI w [CLIProxyAPI](https://github.com/router-for-me/CLIProxyAPI).
`AI_BASE_URL` to bazowy URL API zgodnego z OpenAI, zawierający prefiks wersji dostawcy, jeśli jest wymagany. Nie dopisuj `/chat/completions`, ponieważ dodajemy to wewnętrznie. Bramka i model muszą obsługiwać strumieniowe uzupełnienia czatu (streaming chat completions) oraz narzędzia funkcyjne (function tools). Obie funkcje wysyłają kontekst dokumentu do tej bramki; czat może również wysyłać przesłane obrazy, jeśli używany jest model obsługujący obrazy.
Toolkit przekazuje `config/variables.env` do kontenera aplikacji. Zachowaj podane tutaj nazwy zmiennych; nie dodawaj prefiksu `OVERLEAF_`. Po zmianie tych zmiennych odtwórz kontener aplikacji z katalogu Toolkit:
```sh theme={null}
bin/up -d
```
### Ustawienia bramki
| Zmienna | Domyślnie | Przeznaczenie |
| - | - | - |
| `AI_ENABLED` | `false` | Ustaw dokładnie `true`, aby włączyć czat i sugestie dotyczące błędów dla instancji. Brak wartości lub dowolna inna wartość pozostawia je wyłączone. Wymagana jest również działająca konfiguracja bramki. |
| `AI_BASE_URL` | Brak; wymagane | Bazowy URL API zgodnego z OpenAI. |
| `AI_API_KEY` | Brak; wymagane | Klucz API dla tej bramki, używany przez serwer. |
| `AI_MODEL` | Brak; wymagane | Model tekstowy używany przez domyślną konfigurację czatu oraz przez sugestie dotyczące błędów LaTeX. |
| `AI_IMAGE_MODEL` | Nieustawione | Opcjonalny model obsługujący obrazy w tej samej bramce, korzystający z tego samego klucza API. |
| `AI_MAX_STEPS` | `20` | Maksymalna liczba wywołań narzędzi na jedną wiadomość użytkownika w czacie AI, łącznie z automatycznymi kontynuacjami. Użyj dodatniej liczby całkowitej. |
| `AI_PROXY_URL` | Nieustawione | Opcjonalny URL proxy HTTP dla wywołań bramki AI. Nie konfiguruje klientów wyszukiwania w sieci ani w dokumentacji. |
| `AI_TOKEN_QUOTA` | `0` | Limit tokenów na użytkownika, wspólny dla czatu i sugestii dotyczących błędów w każdym okresie. Brak wartości lub `0` oznacza brak limitu; użyj dodatniej liczby całkowitej, aby ustawić limit. |
| `AI_TOKEN_QUOTA_PERIOD` | `month` | `month` resetuje się pierwszego dnia miesiąca o 00:00 UTC; `week` resetuje się w poniedziałek o 00:00 UTC. Inne wartości działają jak `month`. |
Aby umożliwić przesyłanie obrazów, ustaw `AI_IMAGE_MODEL` na model, który przyjmuje obrazy jako dane wejściowe i obsługuje narzędzia używane przez czat. Każde żądanie czatu, którego historia zawiera załącznik graficzny, korzysta z tego modelu — również kolejne wiadomości w tej rozmowie. Bez tego ustawienia żądania z obrazami używają zwykłego modelu czatu, który sam musi obsługiwać obrazy. Sugestie dotyczące błędów LaTeX nadal używają `AI_MODEL`.
Na przykład, aby włączyć model obsługujący obrazy i tygodniowy limit AI:
```dotenv theme={null}
AI_IMAGE_MODEL=YOUR_IMAGE_CAPABLE_MODEL_ID
AI_TOKEN_QUOTA=100000
AI_TOKEN_QUOTA_PERIOD=week
```
### Dostęp użytkowników i zgoda
Dostępność w instancji i uprawnienia użytkownika to odrębne kwestie. `AI_ENABLED` oraz konfiguracja bramki decydują o dostępności w instancji. Zalogowany użytkownik musi ponadto przejść istniejące kontrole konta:
* `aiFeatures.enabled` nie może mieć wartości `false`. To istniejące pole bazy danych steruje zarówno czatem, jak i sugestiami dotyczącymi błędów LaTeX.
* Efektywna wartość `features.aiUsageQuota` użytkownika musi odpowiadać skonfigurowanemu poziomowi bez limitu (domyślnie `unlimited`) lub musi być włączone istniejące starsze uprawnienie `features.aiErrorAssistant`. Efektywne funkcje uwzględniają odpowiednie nadpisania funkcji konta.
Samo zaznaczenie pola wyboru nie zmienia planu użytkownika. Pole `aiUsageQuota` jest poziomem uprawnień, a nie liczbowym przydziałem tokenów. `AI_TOKEN_QUOTA` to osobny limit stosowany jednakowo do każdego uprawnionego użytkownika; obecny moduł nie zapewnia indywidualnego limitu liczbowego dla poszczególnych kont.
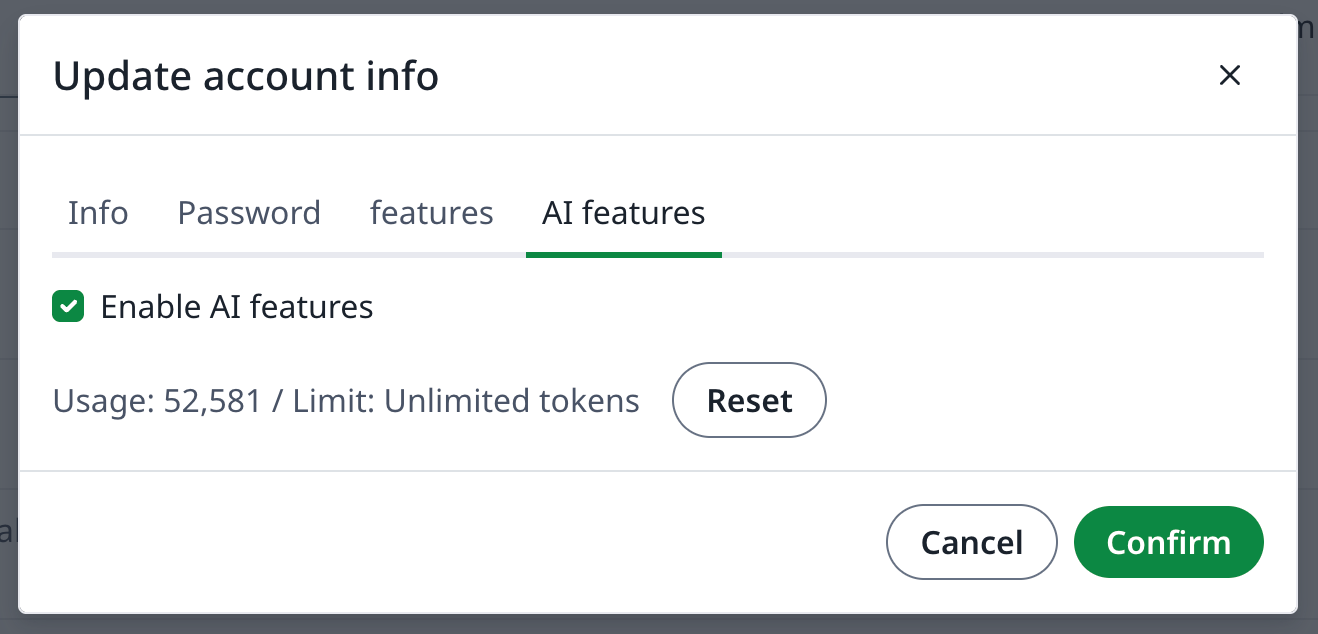
Na liście użytkowników w panelu administratora wybierz użytkownika i otwórz **Update account info → AI features**. **Enable AI features** aktualizuje `aiFeatures.enabled` po zapisaniu zmian konta. Serwer sprawdza bieżące uprawnienia przy nowych żądaniach AI, w tym przy żądaniach z już otwartego edytora. Po zmianie uprawnień odśwież edytor, aby zaktualizować widoczne elementy sterujące.
### Zużycie i resetowanie
Karta AI features w panelu administratora pokazuje w jednym wierszu **Usage** bieżącego okresu, **Limit** oraz przycisk **Reset**. Zużycie jest odczytywane przy otwarciu karty i nie jest odświeżane na bieżąco. Aby zobaczyć najnowszą wartość, otwórz kartę ponownie po zakończeniu czatu lub sugestii dotyczącej błędu. Reset działa natychmiast i zeruje wyłącznie licznik bieżącego okresu danego użytkownika, a następnie ponownie wczytuje wyświetlane zużycie. Nie wymaga zapisywania pozostałej części formularza konta.
 Zużycie czatu i sugestii dotyczących błędów współdzieli jeden licznik Redis, aktualizowany po zakończeniu żądania na podstawie łącznej liczby tokenów zgłoszonej przez dostawcę modelu. Obejmuje to tokeny wejściowe i wyjściowe we wszystkich krokach modelu. Dane wejściowe mogą zawierać historię rozmowy, kontekst dokumentu i wyniki narzędzi, więc kolejna wiadomość może zużyć więcej tokenów niż sama nowa wiadomość. Zużycie jest rejestrowane nawet wtedy, gdy limit ma wartość **Unlimited**. Żądania bez zgłoszonej łącznej liczby tokenów nie zwiększają licznika; moduł nie może odtworzyć historycznego, niezarejestrowanego zużycia.
Sprawdzanie limitu odbywa się przed rozpoczęciem strumieniowania. Jedno żądanie lub kilka równoczesnych żądań może przekroczyć pozostały przydział, zanim kolejne żądania zostaną zablokowane. Jest to przydział zużycia, a nie ścisły limit wydatków u dostawcy. Jeśli sprawdzenie limitu się nie powiedzie, żądanie jest dopuszczane, a błąd zostaje zapisany w logach.
Obie funkcje korzystają z `AI_TOKEN_QUOTA`; sugestie dotyczące błędów nie mają osobnego limitu liczby żądań. Zresetowanie licznika nie zmienia uprawnień, zgody, skonfigurowanego limitu ani rozliczeń prowadzonych przez dostawcę. Liczniki używają kluczy okresów w UTC i wygasają po 40 dniach; zachowanie danych Redis pozwala utrzymać bieżące zużycie po restarcie aplikacji.
### Opcjonalne usługi wyszukiwania
Wyszukiwanie w sieci korzysta z API zgodnego z Tavily. Jest dostępne, gdy skonfigurowano klucz API wyszukiwania. Te ustawienia są niezależne od bramki AI:
| Zmienna | Domyślnie | Przeznaczenie |
| - | - | - |
| `TAVILY_API_KEY` | Nieustawione | Klucz API wyszukiwania. Ma pierwszeństwo przed `WEB_SEARCH_API_KEY`. |
| `WEB_SEARCH_API_KEY` | Nieustawione | Alternatywna nazwa klucza API wyszukiwania. |
| `WEB_SEARCH_URL` | `https://api.tavily.com/search` | Endpoint wyszukiwania; niestandardowe endpointy muszą obsługiwać format żądań i odpowiedzi Tavily. |
| `WEB_SEARCH_MAX_RESULTS` | `5` | Liczba wyników żądanych na jedno wyszukiwanie; użyj dodatniej liczby całkowitej obsługiwanej przez usługę. |
| `WEB_SEARCH_DEPTH` | `basic` | Głębokość wyszukiwania, zwykle `basic` lub `advanced`. |
| `WEB_SEARCH_PROVIDER` | `tavily` | Obecna implementacja obsługuje wyłącznie protokół zgodny z Tavily; zmiana tej wartości nie wybiera innego adaptera. |
| `DOCS_MCP_URL` | `https://docs.overleaf.com/~gitbook/mcp` | Endpoint wyszukiwania w dokumentacji. Ustaw pusty ciąg znaków, aby wyłączyć wyszukiwanie w dokumentacji. |
Na przykład:
```dotenv theme={null}
TAVILY_API_KEY=REPLACE_WITH_YOUR_SEARCH_API_KEY
WEB_SEARCH_MAX_RESULTS=5
WEB_SEARCH_DEPTH=basic
DOCS_MCP_URL=https://docs.overleaf.com/~gitbook/mcp
```
Wyszukiwanie w dokumentacji wywołuje narzędzie `searchDocumentation` skonfigurowanego endpointu GitBook MCP i akceptuje odpowiedzi JSON lub SSE. Jest to klient MCP do wyszukiwania w dokumentacji; moduły te nie udostępniają plików projektu jako serwera MCP ani nie zapewniają rejestru serwerów MCP ogólnego przeznaczenia.
Zapytania wyszukiwania trafiają do skonfigurowanej usługi wyszukiwania. Wyniki wyszukiwania mogą następnie zostać dołączone do żądań wysyłanych do bramki AI. Menu **Tools** w czacie pozwala użytkownikom włączać lub wyłączać **Web** i **Documentation** dla swoich żądań; aby narzędzie było dostępne dla modelu, musi być także skonfigurowane na serwerze.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.