> ## Documentation Index
> Fetch the complete documentation index at: https://ayakaleaf-pro.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# Integración de IA
> Configura el chat con IA, las sugerencias para errores de LaTeX, el acceso de los usuarios, las cuotas y los servicios de búsqueda opcionales.
Esta función la proporciona [ayaka-notes/ayakaleaf-pro](https://github.com/ayaka-notes/ayakaleaf-pro) y está disponible a partir de la v6.3.0. Agradecemos tus comentarios si encuentras algún problema.
## Asistente de IA y asistente de errores de LaTeX
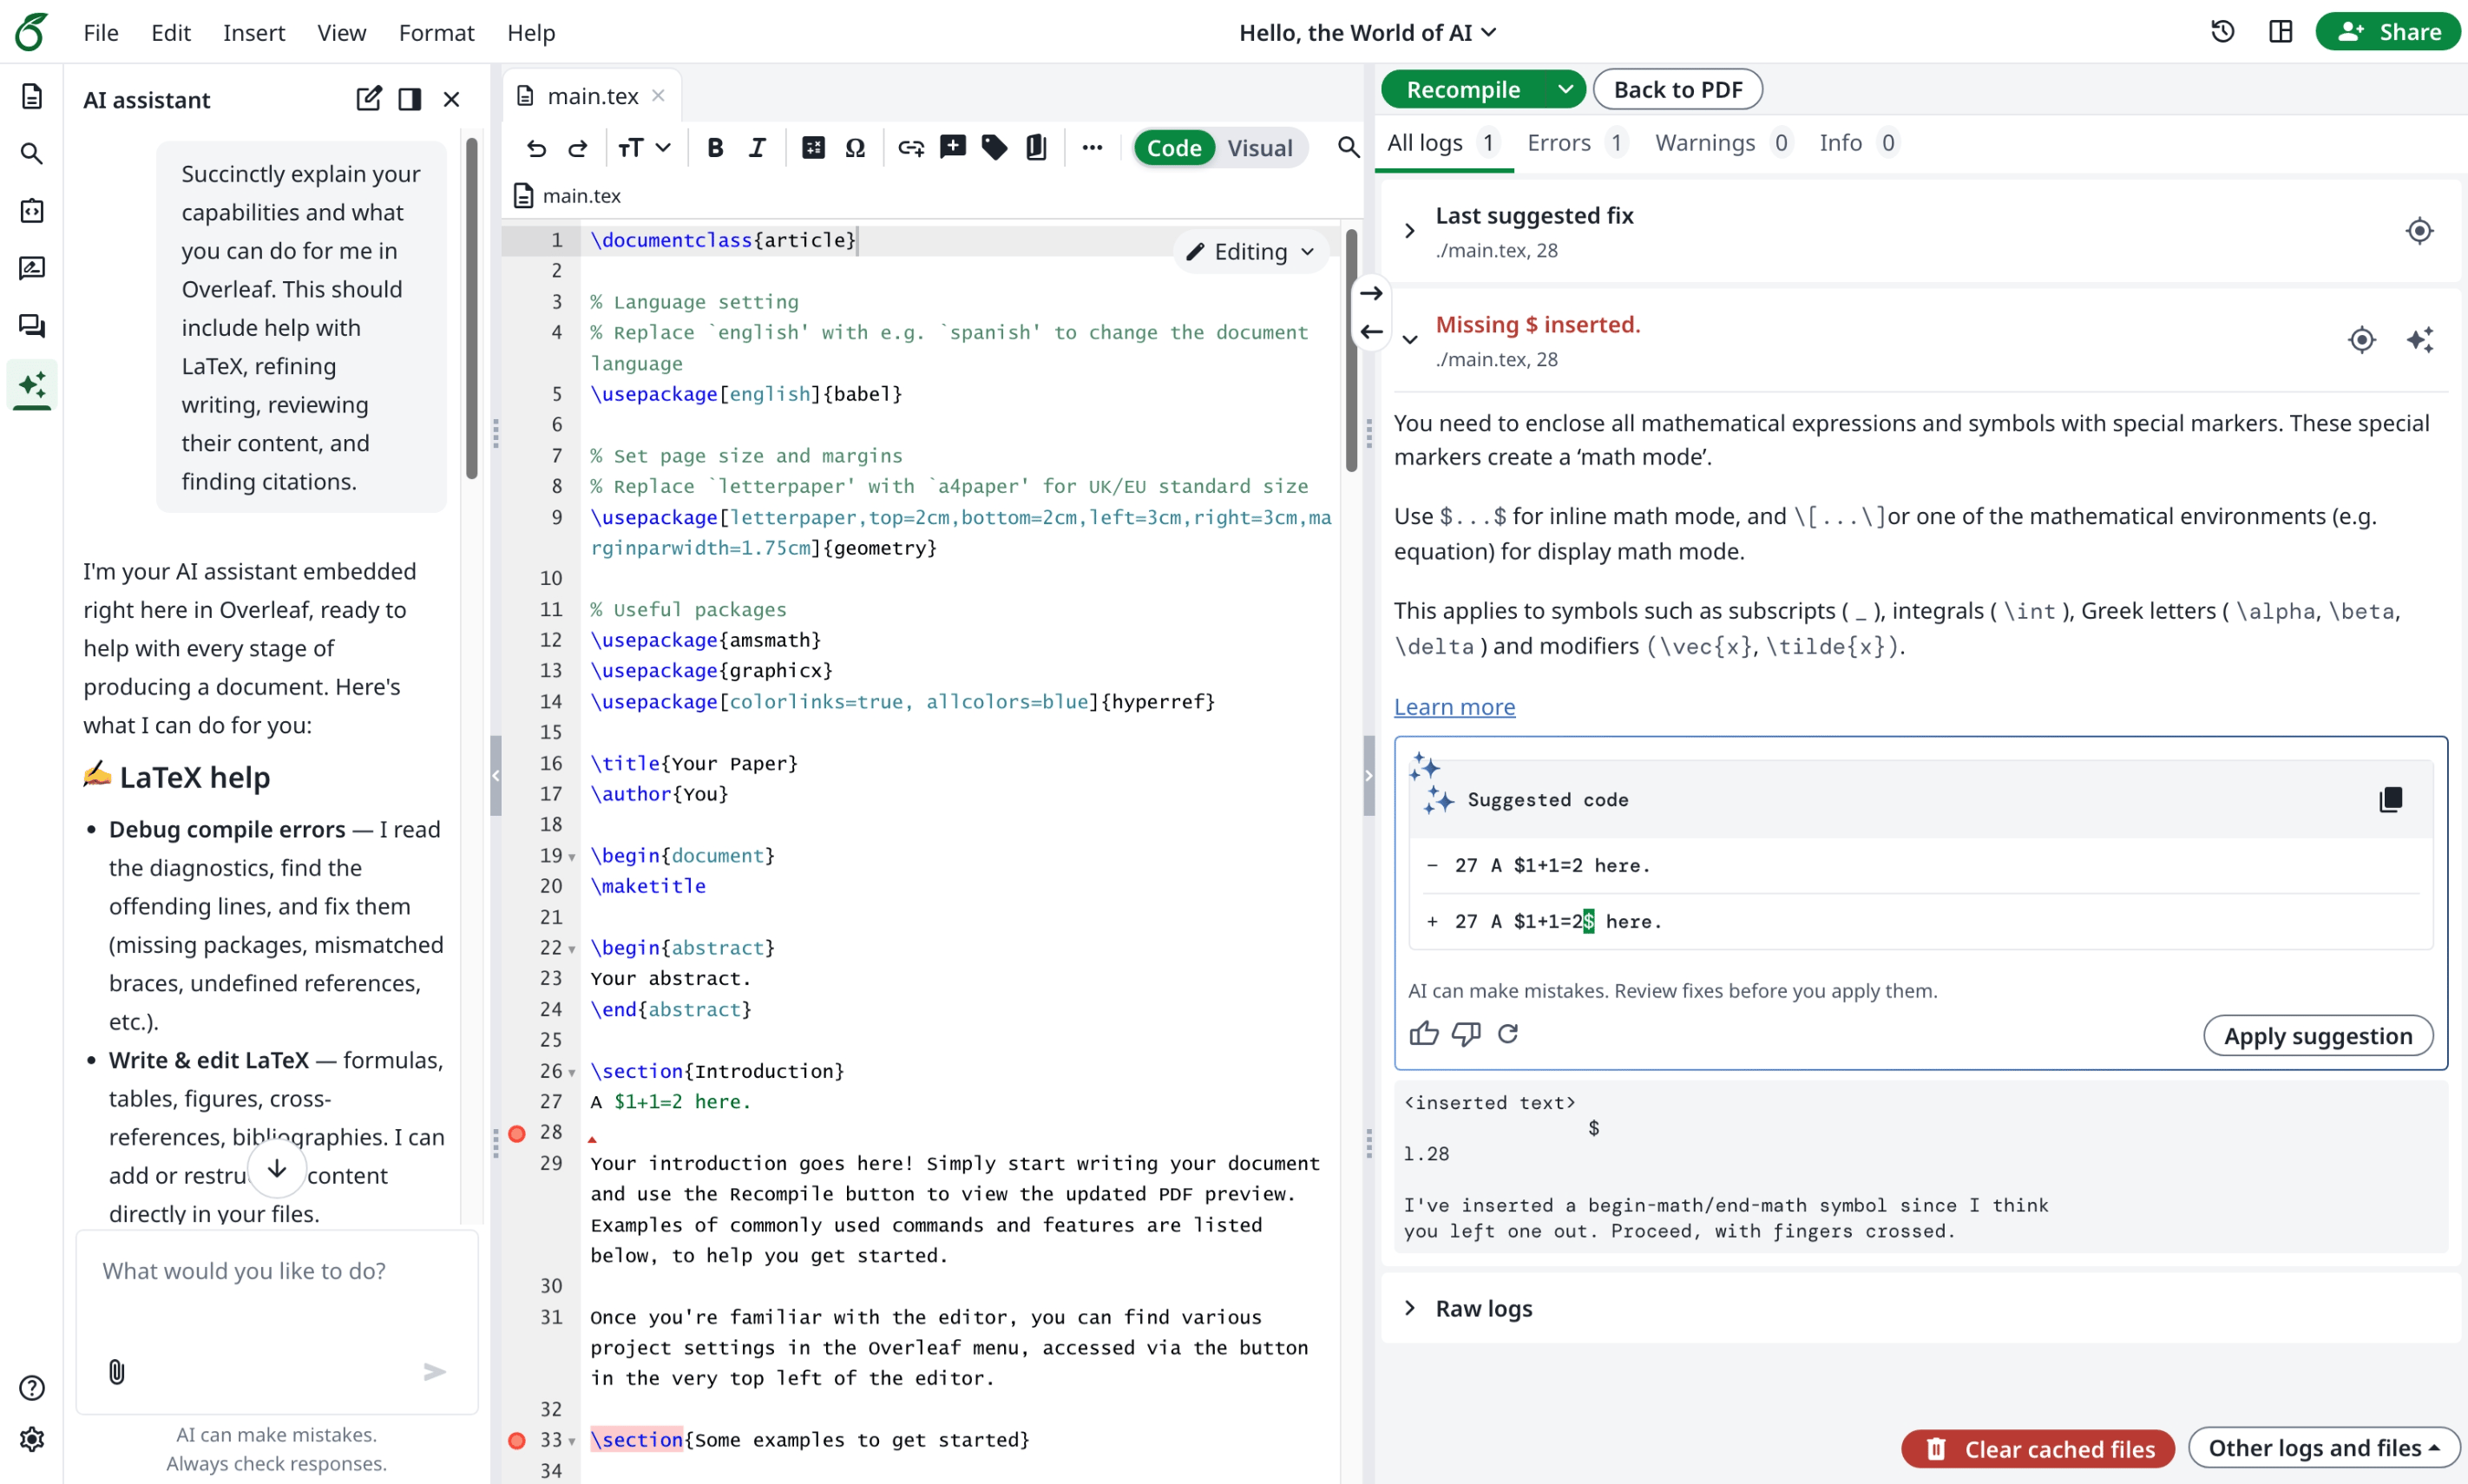
Ayakaleaf Pro incorpora funciones de IA al editor de 2 maneras.
* El asistente de IA puede usar los documentos de tu proyecto y la selección actual como contexto para responder preguntas y sugerir cambios para que los revises.
* El asistente de errores propone una corrección concreta cuando seleccionas un error de compilación de LaTeX.
 ### Configuración del Toolkit
Añade lo siguiente a `config/variables.env` en tu despliegue del Toolkit, sustituyendo la URL, la clave y el modelo de ejemplo por los valores de tu proveedor:
```dotenv theme={null}
AI_ENABLED=true
AI_BASE_URL=https://ai-gateway.example.com/v1
AI_API_KEY=REPLACE_WITH_YOUR_GATEWAY_API_KEY
AI_MODEL=YOUR_TEXT_MODEL_ID
```
Guarda las claves de API reales en el archivo de entorno de tu despliegue y fuera del control de versiones. Los valores anteriores son marcadores de posición, no credenciales válidas.
La calidad de las sugerencias de IA depende del modelo que elijas. Si ya tienes una suscripción a Codex o ChatGPT, puedes conectarla mediante el endpoint compatible con OpenAI de [CLIProxyAPI](https://github.com/router-for-me/CLIProxyAPI).
`AI_BASE_URL` es la URL base de la API compatible con OpenAI, incluido el prefijo de versión del proveedor cuando sea necesario. No añadas `/chat/completions`, ya que lo añadimos internamente. El gateway y el modelo deben admitir chat completions en streaming y herramientas de funciones (function tools). Ambas funciones envían contexto del documento a este gateway; el chat también puede enviar imágenes subidas si se usa un modelo con capacidad para imágenes.
El Toolkit reenvía `config/variables.env` al contenedor de la aplicación. Mantén los nombres de variables que se muestran aquí; no añadas el prefijo `OVERLEAF_`. Desde el directorio del Toolkit, vuelve a crear el contenedor de la aplicación después de cambiar estas variables:
```sh theme={null}
bin/up -d
```
### Configuración del gateway
| Variable | Valor predeterminado | Propósito |
| - | - | - |
| `AI_ENABLED` | `false` | Establécela exactamente en `true` para habilitar el chat y las sugerencias de errores en la instancia. Si no está definida o tiene cualquier otro valor, permanecen deshabilitadas. También se requiere una configuración de gateway que funcione. |
| `AI_BASE_URL` | Ninguno; obligatorio | URL base de la API compatible con OpenAI. |
| `AI_API_KEY` | Ninguno; obligatorio | Clave de API de ese gateway, utilizada por el servidor. |
| `AI_MODEL` | Ninguno; obligatorio | Modelo de texto utilizado por la configuración de chat predeterminada y por las sugerencias de errores de LaTeX. |
| `AI_IMAGE_MODEL` | Sin definir | Modelo opcional con capacidad para imágenes en el mismo gateway, que usa la misma clave de API. |
| `AI_MAX_STEPS` | `20` | Número máximo de llamadas a herramientas por mensaje de usuario en el chat con IA, incluidas las continuaciones automáticas. Usa un entero positivo. |
| `AI_PROXY_URL` | Sin definir | URL opcional de un proxy HTTP para las llamadas al gateway de IA. No configura los clientes de búsqueda web ni de búsqueda en la documentación. |
| `AI_TOKEN_QUOTA` | `0` | Límite de tokens por usuario, compartido por el chat y las sugerencias de errores en cada período. Sin definir o `0` significa ilimitado; usa un entero positivo para establecer un límite. |
| `AI_TOKEN_QUOTA_PERIOD` | `month` | `month` se restablece el primer día a las 00:00 UTC; `week` se restablece el lunes a las 00:00 UTC. Cualquier otro valor usa `month`. |
Para la subida de imágenes, establece `AI_IMAGE_MODEL` en un modelo que acepte imágenes como entrada y admita las herramientas que usa el chat. Cualquier solicitud de chat cuyo historial contenga una imagen adjunta usa este modelo, incluidos los mensajes posteriores de esa conversación. Sin esta configuración, las solicitudes con imágenes usan el modelo de chat normal, que debe admitir imágenes por sí mismo. Las sugerencias de errores de LaTeX siguen usando `AI_MODEL`.
Por ejemplo, para habilitar un modelo de imágenes y una asignación semanal de IA:
```dotenv theme={null}
AI_IMAGE_MODEL=YOUR_IMAGE_CAPABLE_MODEL_ID
AI_TOKEN_QUOTA=100000
AI_TOKEN_QUOTA_PERIOD=week
```
### Acceso de los usuarios y consentimiento
La disponibilidad en la instancia y el permiso de cada usuario son cosas distintas. `AI_ENABLED` y la configuración del gateway controlan la disponibilidad en la instancia. Además, un usuario con sesión iniciada debe superar las comprobaciones de cuenta existentes:
* `aiFeatures.enabled` no debe ser `false`. Este campo existente de la base de datos controla tanto el chat como las sugerencias de errores de LaTeX.
* El valor efectivo de `features.aiUsageQuota` del usuario debe coincidir con el nivel ilimitado configurado (`unlimited` de forma predeterminada), o bien debe estar habilitado el permiso heredado `features.aiErrorAssistant`. Las funciones efectivas incluyen las anulaciones de funciones de cuenta aplicables.
Marcar la casilla por sí solo no cambia el plan del usuario. El campo `aiUsageQuota` es un nivel de permiso, no una asignación numérica de tokens. `AI_TOKEN_QUOTA` es un límite independiente que se aplica por igual a cada usuario con permiso; el módulo actual no ofrece un límite numérico individual por cuenta.
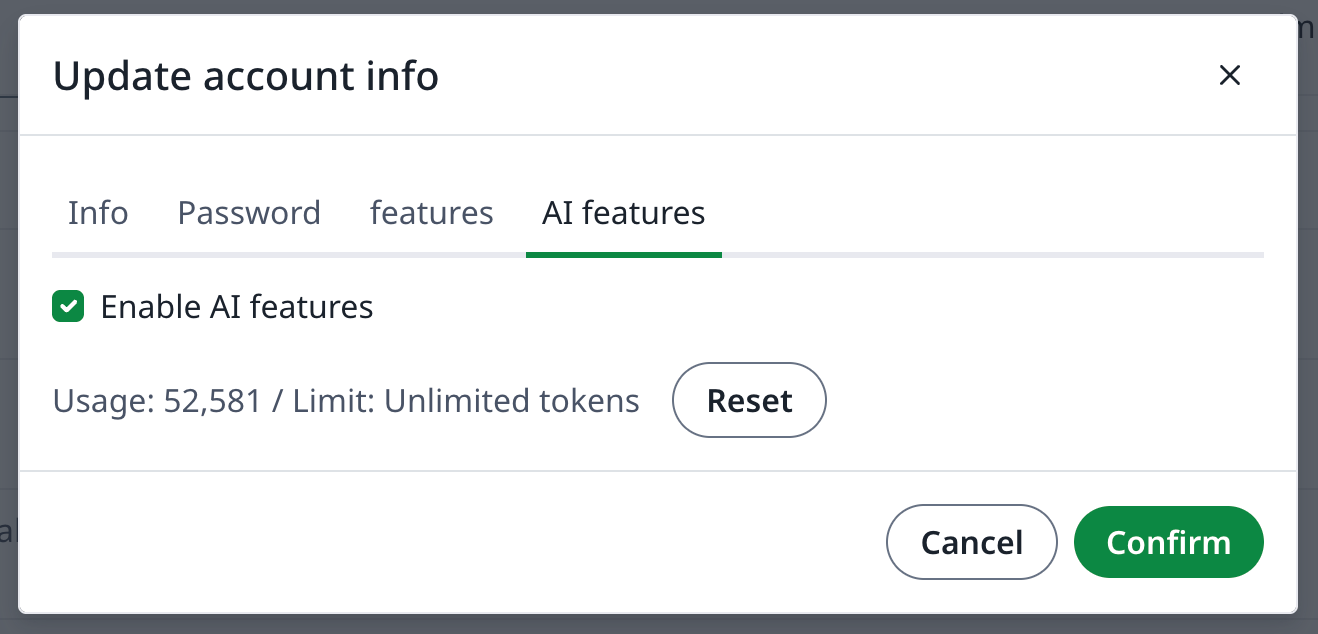
En la lista de usuarios del panel de administración, selecciona un usuario y abre **Update account info → AI features**. **Enable AI features** actualiza `aiFeatures.enabled` cuando se guardan los cambios de la cuenta. El servidor comprueba los permisos actuales en cada nueva solicitud de IA, incluidas las solicitudes desde un editor ya abierto. Actualiza el editor para que sus controles visibles reflejen un cambio de permisos.
### Uso y restablecimiento
La pestaña de funciones de IA del panel de administración muestra en una sola fila el **Usage** del período actual, el **Limit** y el botón **Reset**. El uso se lee al abrir la pestaña; no se actualiza de forma continua. Vuelve a abrir la pestaña cuando termine un chat o una sugerencia de errores para ver el recuento más reciente. El restablecimiento surte efecto inmediatamente y solo borra el contador del período actual de ese usuario; después vuelve a cargar el uso mostrado. No es necesario guardar el resto del formulario de la cuenta.
 El uso del chat y de las sugerencias de errores comparte un único contador de Redis, que se actualiza con el total de tokens notificado por el proveedor del modelo una vez finalizada la solicitud. Esto incluye los tokens de entrada y de salida de todos los pasos del modelo. La entrada puede incluir el historial de la conversación, el contexto del documento y los resultados de las herramientas, por lo que un mensaje de seguimiento puede consumir más tokens que el nuevo mensaje por sí solo. El uso se registra incluso cuando el límite es **Unlimited**. Las solicitudes sin un total de tokens notificado no se suman al contador; el módulo no puede reconstruir el uso histórico no registrado.
Las comprobaciones de cuota se realizan antes del streaming. Una solicitud, o varias solicitudes simultáneas, pueden superar la asignación restante antes de que se bloqueen las solicitudes posteriores. Se trata de una asignación de uso y no de un tope estricto de gasto con el proveedor. Si falla la consulta de la cuota, la solicitud se permite y el fallo se registra.
Ambas funciones usan `AI_TOKEN_QUOTA`; las sugerencias de errores no tienen un límite independiente de número de solicitudes. Restablecer el contador no cambia el permiso, el consentimiento, el límite configurado ni los registros de facturación del propio proveedor. Los contadores usan claves de período en UTC y caducan a los 40 días; conservar los datos de Redis mantiene el uso actual tras reiniciar la aplicación.
### Servicios de búsqueda opcionales
La búsqueda web usa una API compatible con Tavily. Está disponible cuando se configura una clave de API de búsqueda. Estos ajustes son independientes del gateway de IA:
| Variable | Valor predeterminado | Propósito |
| - | - | - |
| `TAVILY_API_KEY` | Sin definir | Clave de API de búsqueda. Tiene prioridad sobre `WEB_SEARCH_API_KEY`. |
| `WEB_SEARCH_API_KEY` | Sin definir | Nombre alternativo para la clave de API de búsqueda. |
| `WEB_SEARCH_URL` | `https://api.tavily.com/search` | Endpoint de búsqueda; los endpoints personalizados deben aceptar el formato de solicitud y respuesta de Tavily. |
| `WEB_SEARCH_MAX_RESULTS` | `5` | Resultados solicitados por búsqueda; usa un entero positivo admitido por el servicio. |
| `WEB_SEARCH_DEPTH` | `basic` | Profundidad de búsqueda, normalmente `basic` o `advanced`. |
| `WEB_SEARCH_PROVIDER` | `tavily` | La implementación actual solo admite el protocolo compatible con Tavily; cambiar este valor no selecciona otro adaptador. |
| `DOCS_MCP_URL` | `https://docs.overleaf.com/~gitbook/mcp` | Endpoint de búsqueda en la documentación. Establécelo como cadena vacía para deshabilitar la búsqueda en la documentación. |
Por ejemplo:
```dotenv theme={null}
TAVILY_API_KEY=REPLACE_WITH_YOUR_SEARCH_API_KEY
WEB_SEARCH_MAX_RESULTS=5
WEB_SEARCH_DEPTH=basic
DOCS_MCP_URL=https://docs.overleaf.com/~gitbook/mcp
```
La búsqueda en la documentación llama a la herramienta `searchDocumentation` del endpoint MCP de GitBook configurado y acepta respuestas JSON o SSE. Se trata de un cliente MCP para buscar en la documentación; estos módulos no exponen los archivos del proyecto como servidor MCP ni ofrecen un registro de servidores MCP de uso general.
Las consultas de búsqueda se envían al servicio de búsqueda configurado. Los resultados de búsqueda pueden incluirse después en las solicitudes al gateway de IA. El menú **Tools** del chat permite a los usuarios habilitar o deshabilitar **Web** y **Documentation** en sus solicitudes; además, una herramienta debe estar configurada en el servidor para que esté disponible para el modelo.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.