> ## Documentation Index
> Fetch the complete documentation index at: https://ayakaleaf-pro.mintlify.site/llms.txt
> Use this file to discover all available pages before exploring further.
# KI-Integration
> Konfigurieren Sie KI-Chat, Vorschläge für LaTeX-Fehler, Benutzerzugriff, Kontingente und optionale Suchdienste.
Diese Funktion wird von [ayaka-notes/ayakaleaf-pro](https://github.com/ayaka-notes/ayakaleaf-pro) bereitgestellt und ist ab v6.3.0 verfügbar. Wir freuen uns über Ihr Feedback, falls Probleme auftreten.
## KI-Assistent und LaTeX-Fehlerassistent
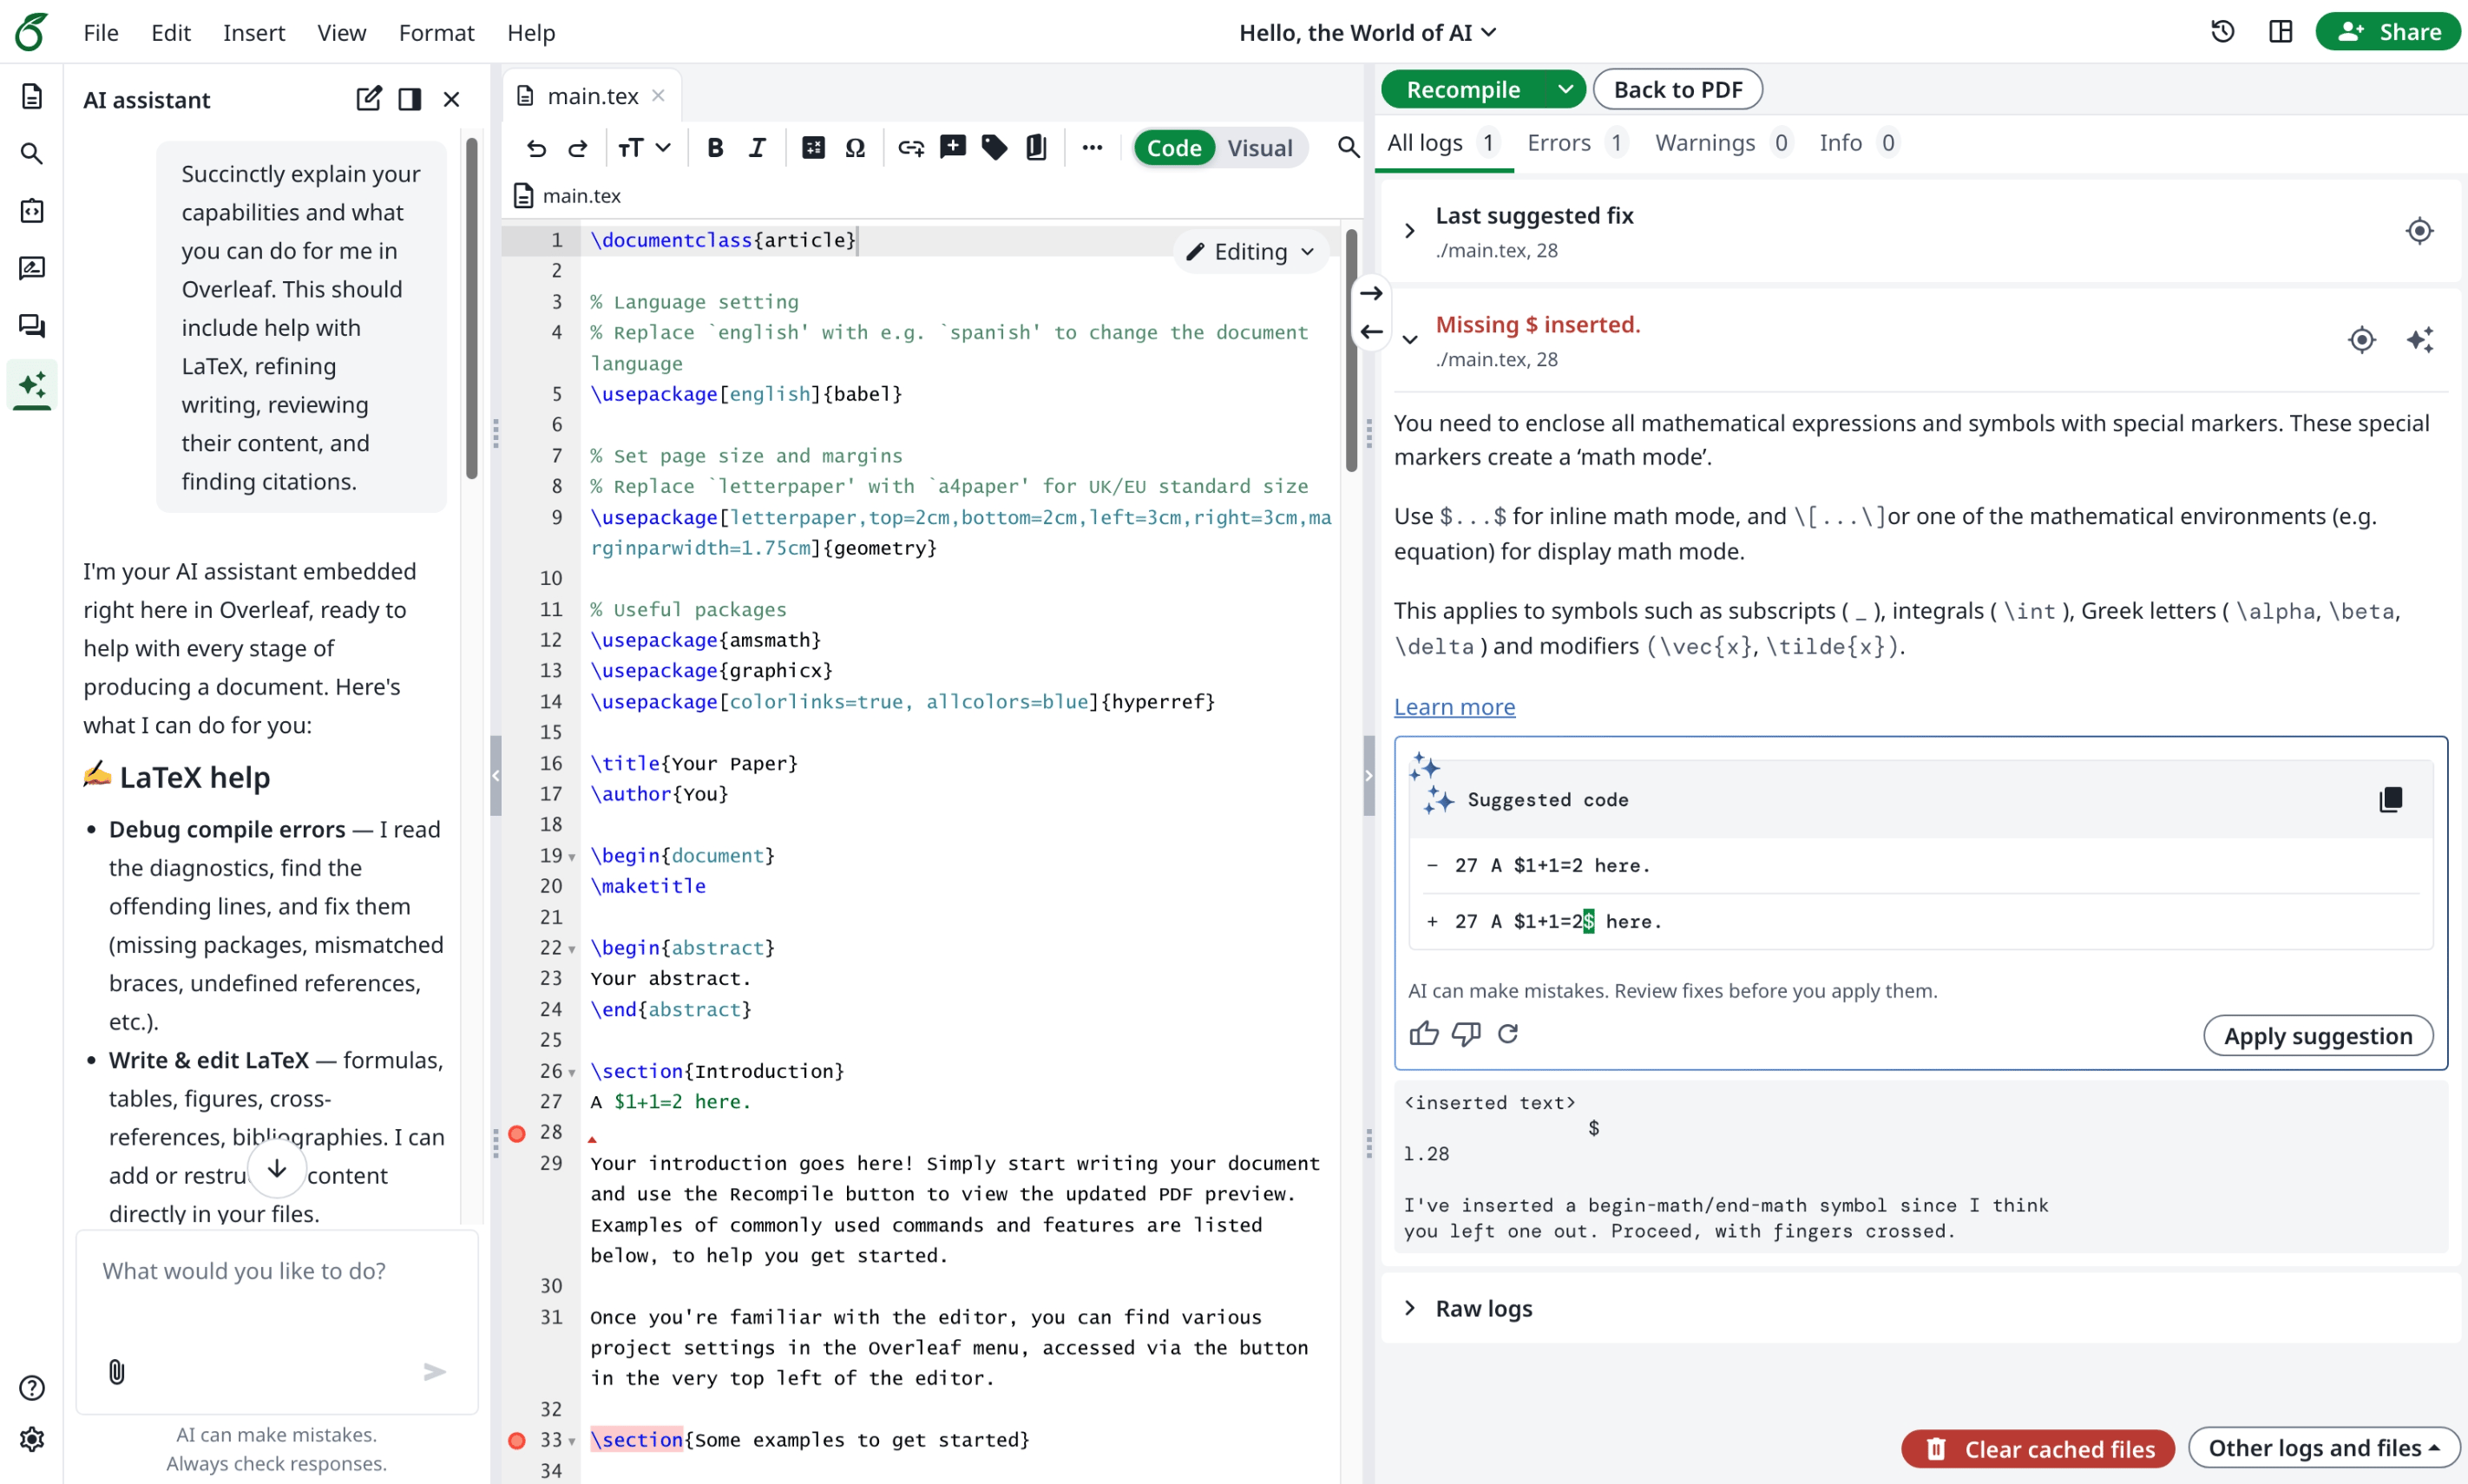
Ayakaleaf Pro bringt KI-Funktionen auf zwei Arten in den Editor.
* Der KI-Assistent kann Ihre Projektdokumente und die aktuelle Auswahl als Kontext nutzen, um Fragen zu beantworten und Änderungen vorzuschlagen, die Sie anschließend prüfen.
* Der Fehlerassistent schlägt eine gezielte Korrektur vor, wenn Sie einen LaTeX-Kompilierungsfehler auswählen.
 ### Toolkit-Konfiguration
Fügen Sie Folgendes zu `config/variables.env` in Ihrem Toolkit-Deployment hinzu und ersetzen Sie die Beispiel-URL, den Schlüssel und das Modell durch die Werte Ihres Anbieters:
```dotenv theme={null}
AI_ENABLED=true
AI_BASE_URL=https://ai-gateway.example.com/v1
AI_API_KEY=REPLACE_WITH_YOUR_GATEWAY_API_KEY
AI_MODEL=YOUR_TEXT_MODEL_ID
```
Bewahren Sie echte API-Schlüssel in der Umgebungsdatei Ihres Deployments auf und nicht in der Versionskontrolle. Die obigen Werte sind Platzhalter, keine funktionierenden Zugangsdaten.
Die Qualität der KI-Vorschläge hängt vom gewählten Modell ab. Wenn Sie bereits ein Codex- oder ChatGPT-Abonnement haben, können Sie es über den OpenAI-kompatiblen Endpunkt von [CLIProxyAPI](https://github.com/router-for-me/CLIProxyAPI) anbinden.
`AI_BASE_URL` ist die Basis-URL der OpenAI-kompatiblen API, gegebenenfalls einschließlich des Versionspräfixes des Anbieters. Hängen Sie nicht `/chat/completions` an, da dies intern ergänzt wird. Gateway und Modell müssen Streaming-Chat-Completions und Function Tools unterstützen. Beide Funktionen senden Dokumentkontext an dieses Gateway; der Chat kann bei Verwendung eines bildfähigen Modells auch hochgeladene Bilder senden.
Das Toolkit leitet `config/variables.env` an den Anwendungscontainer weiter. Behalten Sie die hier gezeigten Variablennamen bei; fügen Sie kein `OVERLEAF_`-Präfix hinzu. Erstellen Sie den Anwendungscontainer nach dem Ändern dieser Variablen aus dem Toolkit-Verzeichnis heraus neu:
```sh theme={null}
bin/up -d
```
### Gateway-Einstellungen
| Variable | Standardwert | Zweck |
| - | - | - |
| `AI_ENABLED` | `false` | Setzen Sie den Wert exakt auf `true`, um Chat und Fehlervorschläge für die Instanz zu aktivieren. Ist die Variable nicht gesetzt oder hat einen anderen Wert, bleiben sie deaktiviert. Zusätzlich ist eine funktionierende Gateway-Konfiguration erforderlich. |
| `AI_BASE_URL` | Keiner; erforderlich | Basis-URL der OpenAI-kompatiblen API. |
| `AI_API_KEY` | Keiner; erforderlich | API-Schlüssel für dieses Gateway, der vom Server verwendet wird. |
| `AI_MODEL` | Keiner; erforderlich | Textmodell, das von der Standard-Chat-Konfiguration und den Vorschlägen für LaTeX-Fehler verwendet wird. |
| `AI_IMAGE_MODEL` | Nicht gesetzt | Optionales bildfähiges Modell auf demselben Gateway mit demselben API-Schlüssel. |
| `AI_MAX_STEPS` | `20` | Maximale Anzahl an Tool-Aufrufen pro Benutzernachricht im KI-Chat, einschließlich automatischer Fortsetzungen. Verwenden Sie eine positive ganze Zahl. |
| `AI_PROXY_URL` | Nicht gesetzt | Optionale HTTP-Proxy-URL für Aufrufe an das KI-Gateway. Sie konfiguriert nicht die Clients für die Web- oder Dokumentationssuche. |
| `AI_TOKEN_QUOTA` | `0` | Token-Limit pro Benutzer und Zeitraum, das Chat und Fehlervorschläge gemeinsam nutzen. Nicht gesetzt oder `0` bedeutet unbegrenzt; verwenden Sie eine positive ganze Zahl für ein Limit. |
| `AI_TOKEN_QUOTA_PERIOD` | `month` | `month` wird am ersten Tag des Monats um 00:00 UTC zurückgesetzt; `week` montags um 00:00 UTC. Andere Werte verwenden `month`. |
Für Bild-Uploads setzen Sie `AI_IMAGE_MODEL` auf ein Modell, das Bildeingaben akzeptiert und die vom Chat verwendeten Tools unterstützt. Jede Chat-Anfrage, deren Verlauf einen Bildanhang enthält, verwendet dieses Modell, einschließlich späterer Nachrichten in dieser Unterhaltung. Ohne diese Einstellung verwenden Bildanfragen das normale Chat-Modell, das dann selbst Bilder unterstützen muss. Vorschläge für LaTeX-Fehler verwenden weiterhin `AI_MODEL`.
Zum Beispiel, um ein Bildmodell und ein wöchentliches KI-Kontingent zu aktivieren:
```dotenv theme={null}
AI_IMAGE_MODEL=YOUR_IMAGE_CAPABLE_MODEL_ID
AI_TOKEN_QUOTA=100000
AI_TOKEN_QUOTA_PERIOD=week
```
### Benutzerzugriff und Einwilligung
Die Verfügbarkeit auf Instanzebene und die Benutzerberechtigung sind voneinander getrennt. `AI_ENABLED` und die Gateway-Konfiguration steuern die Verfügbarkeit der Instanz. Ein angemeldeter Benutzer muss außerdem die bestehenden Kontoprüfungen bestehen:
* `aiFeatures.enabled` darf nicht `false` sein. Dieses bestehende Datenbankfeld steuert sowohl den Chat als auch die Vorschläge für LaTeX-Fehler.
* Das effektive `features.aiUsageQuota` des Benutzers muss der konfigurierten unbegrenzten Stufe entsprechen (standardmäßig `unlimited`), oder die bestehende Legacy-Berechtigung `features.aiErrorAssistant` muss aktiviert sein. Zu den effektiven Funktionen zählen auch geltende Funktionsüberschreibungen des Kontos.
Das Aktivieren des Kontrollkästchens allein ändert den Tarif des Benutzers nicht. Das Feld `aiUsageQuota` ist eine Berechtigungsstufe, kein numerisches Token-Kontingent. `AI_TOKEN_QUOTA` ist ein separates Limit, das für jeden berechtigten Benutzer gleichermaßen gilt; das aktuelle Modul bietet kein individuelles numerisches Limit pro Konto.
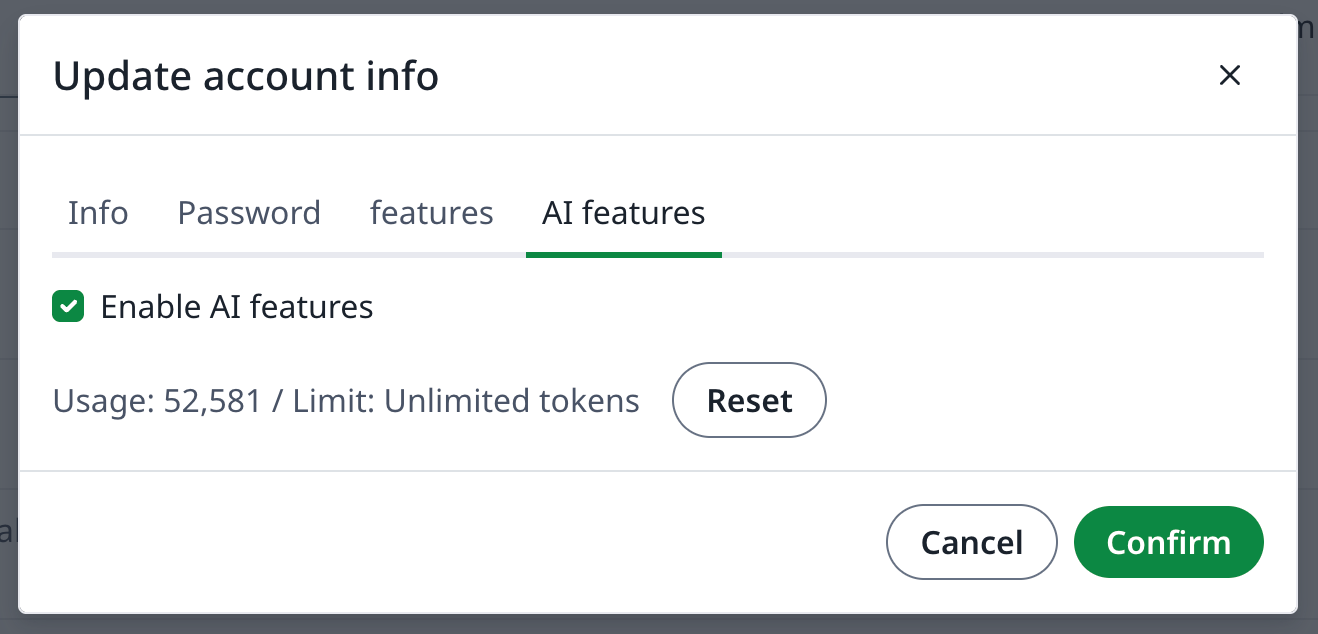
Wählen Sie in der Benutzerliste des Admin-Bereichs einen Benutzer aus und öffnen Sie **Update account info → AI features**. **Enable AI features** aktualisiert `aiFeatures.enabled`, wenn die Kontoänderungen gespeichert werden. Der Server prüft die aktuellen Berechtigungen bei neuen KI-Anfragen, auch bei Anfragen aus einem bereits geöffneten Editor. Laden Sie den Editor nach einer Berechtigungsänderung neu, damit die sichtbaren Bedienelemente aktualisiert werden.
### Nutzung und Zurücksetzen
Der Admin-Tab für KI-Funktionen zeigt die **Usage**, das **Limit** und die Schaltfläche **Reset** des aktuellen Zeitraums in einer Zeile an. Die Nutzung wird beim Öffnen des Tabs gelesen und nicht fortlaufend aktualisiert. Öffnen Sie den Tab erneut, nachdem ein Chat oder Fehlervorschlag abgeschlossen ist, um den aktuellen Stand zu sehen. Das Zurücksetzen wirkt sofort und löscht nur den Zähler dieses Benutzers für den aktuellen Zeitraum; anschließend wird die angezeigte Nutzung neu geladen. Der Rest des Kontoformulars muss dafür nicht gespeichert werden.
 Die Nutzung von Chat und Fehlervorschlägen teilt sich einen Redis-Zähler, der nach Abschluss einer Anfrage anhand der vom Modellanbieter gemeldeten Gesamt-Tokens aktualisiert wird. Dazu gehören Eingabe- und Ausgabe-Tokens über alle Modellschritte hinweg. Die Eingabe kann Gesprächsverlauf, Dokumentkontext und Tool-Ergebnisse enthalten, sodass eine Folgefrage mehr Tokens verbrauchen kann als die neue Nachricht allein. Die Nutzung wird auch dann erfasst, wenn das Limit **Unlimited** ist. Anfragen ohne gemeldete Token-Summe erhöhen den Zähler nicht; historische, nicht erfasste Nutzung kann vom Modul nicht rekonstruiert werden.
Kontingentprüfungen erfolgen vor dem Streaming. Eine Anfrage oder mehrere gleichzeitige Anfragen können das verbleibende Kontingent überschreiten, bevor spätere Anfragen blockiert werden. Es handelt sich also um ein Nutzungskontingent und nicht um eine strikte Ausgabenobergrenze beim Anbieter. Schlägt die Abfrage des Kontingents fehl, wird die Anfrage zugelassen und der Fehler protokolliert.
Beide Funktionen verwenden `AI_TOKEN_QUOTA`; für Fehlervorschläge gibt es kein separates Limit für die Anzahl der Anfragen. Das Zurücksetzen des Zählers ändert weder Berechtigung, Einwilligung, das konfigurierte Limit noch die Abrechnungsdaten des Anbieters. Die Zähler verwenden UTC-basierte Zeitraumschlüssel und laufen nach 40 Tagen ab; wenn Redis-Daten erhalten bleiben, bleibt die aktuelle Nutzung auch über Neustarts der Anwendung hinweg bestehen.
### Optionale Suchdienste
Die Websuche verwendet eine Tavily-kompatible API. Sie ist verfügbar, wenn ein Such-API-Schlüssel konfiguriert ist. Diese Einstellungen sind unabhängig vom KI-Gateway:
| Variable | Standardwert | Zweck |
| - | - | - |
| `TAVILY_API_KEY` | Nicht gesetzt | Such-API-Schlüssel. Hat Vorrang vor `WEB_SEARCH_API_KEY`. |
| `WEB_SEARCH_API_KEY` | Nicht gesetzt | Alternativer Name für den Such-API-Schlüssel. |
| `WEB_SEARCH_URL` | `https://api.tavily.com/search` | Such-Endpunkt; benutzerdefinierte Endpunkte müssen das Tavily-Anfrage- und -Antwortformat akzeptieren. |
| `WEB_SEARCH_MAX_RESULTS` | `5` | Anzahl der angeforderten Ergebnisse pro Suche; verwenden Sie eine vom Dienst unterstützte positive ganze Zahl. |
| `WEB_SEARCH_DEPTH` | `basic` | Suchtiefe, normalerweise `basic` oder `advanced`. |
| `WEB_SEARCH_PROVIDER` | `tavily` | Die aktuelle Implementierung unterstützt nur das Tavily-kompatible Protokoll; eine Änderung dieses Werts wählt keinen anderen Adapter aus. |
| `DOCS_MCP_URL` | `https://docs.overleaf.com/~gitbook/mcp` | Endpunkt für die Dokumentationssuche. Setzen Sie ihn auf eine leere Zeichenkette, um die Dokumentationssuche zu deaktivieren. |
Zum Beispiel:
```dotenv theme={null}
TAVILY_API_KEY=REPLACE_WITH_YOUR_SEARCH_API_KEY
WEB_SEARCH_MAX_RESULTS=5
WEB_SEARCH_DEPTH=basic
DOCS_MCP_URL=https://docs.overleaf.com/~gitbook/mcp
```
Die Dokumentationssuche ruft das Tool `searchDocumentation` des konfigurierten GitBook-MCP-Endpunkts auf und akzeptiert JSON- oder SSE-Antworten. Es handelt sich um einen MCP-Client für die Dokumentationssuche; diese Module stellen Projektdateien weder als MCP-Server bereit noch bieten sie eine allgemeine MCP-Server-Registry.
Suchanfragen werden an den konfigurierten Suchdienst gesendet. Die Suchergebnisse können anschließend in Anfragen an das KI-Gateway einfließen. Über das Menü **Tools** im Chat können Benutzer **Web** und **Documentation** für ihre Anfragen aktivieren oder deaktivieren; ein Tool muss außerdem auf dem Server konfiguriert sein, damit es dem Modell zur Verfügung steht.
This documentation is built and hosted on [Mintlify](https://mintlify.com), a developer documentation platform.